Op een maandagochtend stopt de telefooncentrale van een mkb-bedrijf met meerdere vestigingen met het verdelen van gesprekken. Toestellen melden zich aan en vallen weer weg, de wachtrijen blijven stil en doorverbinden lukt niet meer. In een kliniek merkt de patiëntenbalie dat meteen. In een groter bedrijf lopen verkoop, support en de afstemming tussen vestigingen vast.
Hoge beschikbaarheid van je telefonie gaat dus over meer dan servers die aan blijven staan. Je centrale moet tijdens een storing bereikbaar blijven, gesprekken blijven routeren, haar configuratie bewaren en beheerbaar blijven. Dat hangt af van de infrastructuur van je leverancier, van wat er in je contract staat en van de verbinding tussen je gebruikers en die leverancier.
Een redundante PBX in de cloud helpt je weinig als de glasvezel naar je pand is doorgeknipt. Omgekeerd helpt een reserve-internetlijn niet als de leverancier alles op één locatie draait. Wie als IT-manager, integrator of telecomreseller een cloud-PBX beoordeelt, kijkt daarom naar de hele keten: van de stroomvoorziening in het datacenter tot de laatste aansluiting bij de operator.
Waarom beschikbaarheid van je telefonie kritiek is
Telefonie zit in bijna elk proces, maar veel organisaties merken pas hoe kritiek ze is als ze uitvalt. Valt de telefonische receptie weg, dan liggen de inkomende gesprekken, de keuzemenu's, de wachtrijen en het doorverbinden stil. Collega's kunnen elkaar soms nog via andere kanalen bereiken. Het hoofdnummer blijft alleen wel de ingang voor veel klanten, patiënten en leveranciers, en wie van buiten belt, komt nergens.
Bij een cloud-PBX bestaat beschikbaarheid uit een reeks functies. Het platform moet de registratie van toestellen en apps accepteren, de signalering in stand houden, gesprekken naar de juiste medewerker sturen, de routeringsregels bewaren en de beheerder wijzigingen laten doorvoeren. Servers dubbel uitvoeren garandeert nog niet dat al die functies samen omschakelen. Beoordeel beschikbaarheid daarom op de route die een gesprek aflegt. Wat een server als status toont, zegt daarover weinig.
Redundante servers zijn niet genoeg
Een omgeving kan meerdere machines hebben en toch een single point of failure hebben in de stroomvoorziening, de koeling, de opslag, het netwerk of de aansluiting bij de operator. Hetzelfde risico speelt tijdens onderhoud. Dan kan één gedeeld onderdeel instanties onbereikbaar maken die op verschillende servers draaien.
Het niveau van het datacenter geeft een eerste houvast. Het Uptime Institute deelt datacenters in vier niveaus (tiers) in. Volgens een overzicht van Elipce over datacenters in Frankrijk is Tier III ontworpen voor 99,98% beschikbaarheid, minder dan twee uur uitval per jaar. Tier IV is ontworpen voor 99,995%, ongeveer 26 minuten per jaar. Die niveaus gaan vooral over het ontwerp van de stroom- en koelpaden. Over de veerkracht van de PBX, van de operator of van je eigen internetaansluiting zeggen ze niet vanzelf iets.
Drie dingen die samen moeten kloppen
Een telefonieomgeving die een storing echt doorstaat, heeft drie dingen nodig:
Redundante infrastructuur, met onafhankelijke locaties, netwerken, componenten en stroompaden.
Meetbare afspraken in een SLA (service level agreement), met een hersteltijd en een maximaal dataverlies. In vakjargon heten die twee de RTO (recovery time objective) en de RPO (recovery point objective). Ze horen thuis in je bedrijfscontinuïteitsplan en je herstelplan.
Soevereiniteit en een uitwijkroute. Je data moet in de Europese Economische Ruimte (EER) gehost en verwerkt worden, en er moet een oplossing klaarliggen als je hoofdverbinding wegvalt.
Onder de Europese NIS2-richtlijn over cyberbeveiliging zorgen de lidstaten ervoor dat essentiële en belangrijke entiteiten onder meer maatregelen nemen voor bedrijfscontinuïteit, zoals back-upbeheer, noodvoorzieningenplannen en crisisbeheer (artikel 21 van Richtlijn (EU) 2022/2555). Telefonie moet in die plannen staan zodra de receptie, de bereikbaarheidsdienst, de medische coördinatie of een publieke dienst ervan afhangt.
De cijfers die beschikbaarheid meetbaar maken
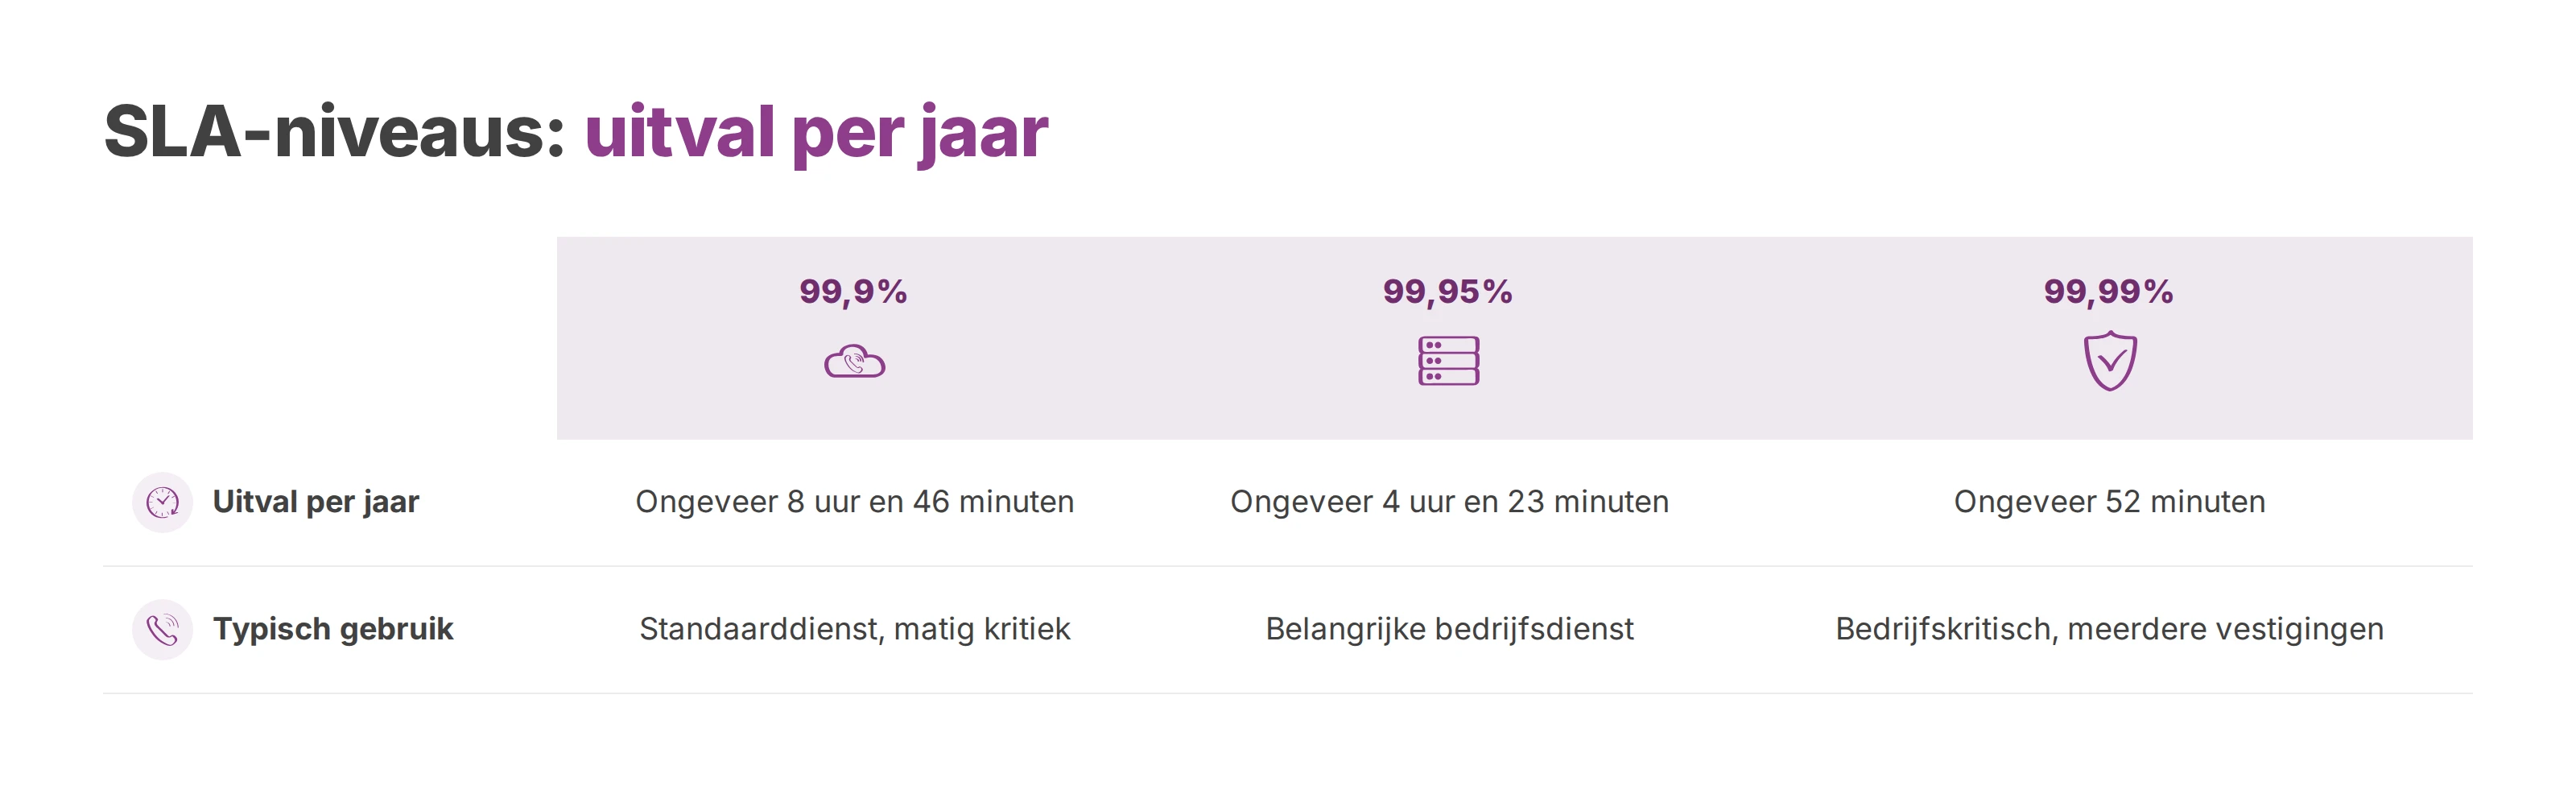
Met alleen een beschikbaarheidspercentage kun je twee offertes niet vergelijken. Een leverancier kan een hoge SLA tonen en je toch zonder antwoord laten over de hersteltijd, het dataverlies of de omschakelprocedure. Lees de cijfers daarom als één geheel.
SLA, RTO en RPO
De SLA is de contractuele belofte van je leverancier. Daarin staan de gedekte beschikbaarheid, wat er precies gemeten wordt, de uitzonderingen en eventuele compensatie. Die garantie is pas iets waard als het contract ook de meetmethode, de meldtermijnen en de voorwaarden voor vergoeding noemt.
De RTO is de doeltijd waarbinnen de dienst na een incident weer draait. De RPO is het maximale dataverlies dat je accepteert, gerekend van de laatste bruikbare kopie tot de storing.
Hoe sterk die waarden per scenario verschillen, laat de SLA van de Franse cloudaanbieder DoliCloud zien. DoliCloud garandeert minstens 99,9% beschikbaarheid, gepland onderhoud niet meegerekend. Voor een storing op één server mikt het op een RPO van 2 minuten en een RTO van 50 minuten. Bij een grote ramp, zoals een brand in het datacenter, worden dat een RPO van 24 uur en een RTO van 48 uur. Het percentage in de SLA vertelt je dus weinig over het herstel na een ramp.
De tijden in de tabel zijn rekenkundige omzettingen van de percentages, geen contractuele toezeggingen. Vraag de leverancier in je aanbesteding om de waarde die voor jou geldt, het meetvenster en de uitzonderingen te bevestigen.
MTBF en MTTR
De MTBF (mean time between failures) is de gemiddelde tijd tussen twee storingen. Het cijfer zegt iets over de betrouwbaarheid van een component of dienst, maar sluit geen storing uit. De MTTR (mean time to repair) is de gemiddelde tijd die het herstel van de werking kost.
Voor een PBX moet je de MTTR per type storing uitsplitsen. Het herstel van een applicatienode, het verlies van een locatie, de uitval van een operator en een doorgeknipte aansluiting bij de klant vragen elk een eigen procedure. Controleer ook of lopende gesprekken in stand blijven, of wachtrijen en keuzemenu's gerepliceerd zijn en of het beheer bereikbaar blijft.
Vergeet de geluidskwaliteit niet. Een dienst die bereikbaar is maar slecht klinkt, is voor een gesprek nauwelijks bruikbaar. Functionele beschikbaarheid omvat dus bereikbaarheid, routering en voldoende spraakkwaliteit.
Architectuur voor telefonie die overeind blijft
Een goede architectuur haalt eerst de gedeelde afhankelijkheden weg en voegt pas daarna slimme mechanismen toe. Georedundantie, loadbalancing, replicatie en failover moeten één samenhangend systeem vormen. Een tweede server in dezelfde technische zone levert geen geografische spreiding op.
Georedundantie en replicatie
Georedundantie verdeelt diensten en data over gescheiden locaties. Zo ben je beschermd tegen een lokaal incident met de stroom, de koeling, het netwerk of de toegang tot het gebouw. Een serieuze leverancier moet precies zeggen wat er gerepliceerd wordt: accounts, toestelnummers, routeringsregels, wachtrijen, keuzemenu's, openingstijden, opnames en beheergegevens.
Replicatie kan active-passive of active-active zijn. Bij active-passive verwerkt een hoofdlocatie de gesprekken en wacht een tweede locatie op de omschakeling. Bij active-active doen meerdere nodes mee en vangt elk een deel van het verkeer op. Active-active benut je capaciteit vollediger. Het vraagt wel strenger beheer van de consistentie en van wat er gebeurt bij een netwerkpartitie (split-brain).
Failover en loadbalancing
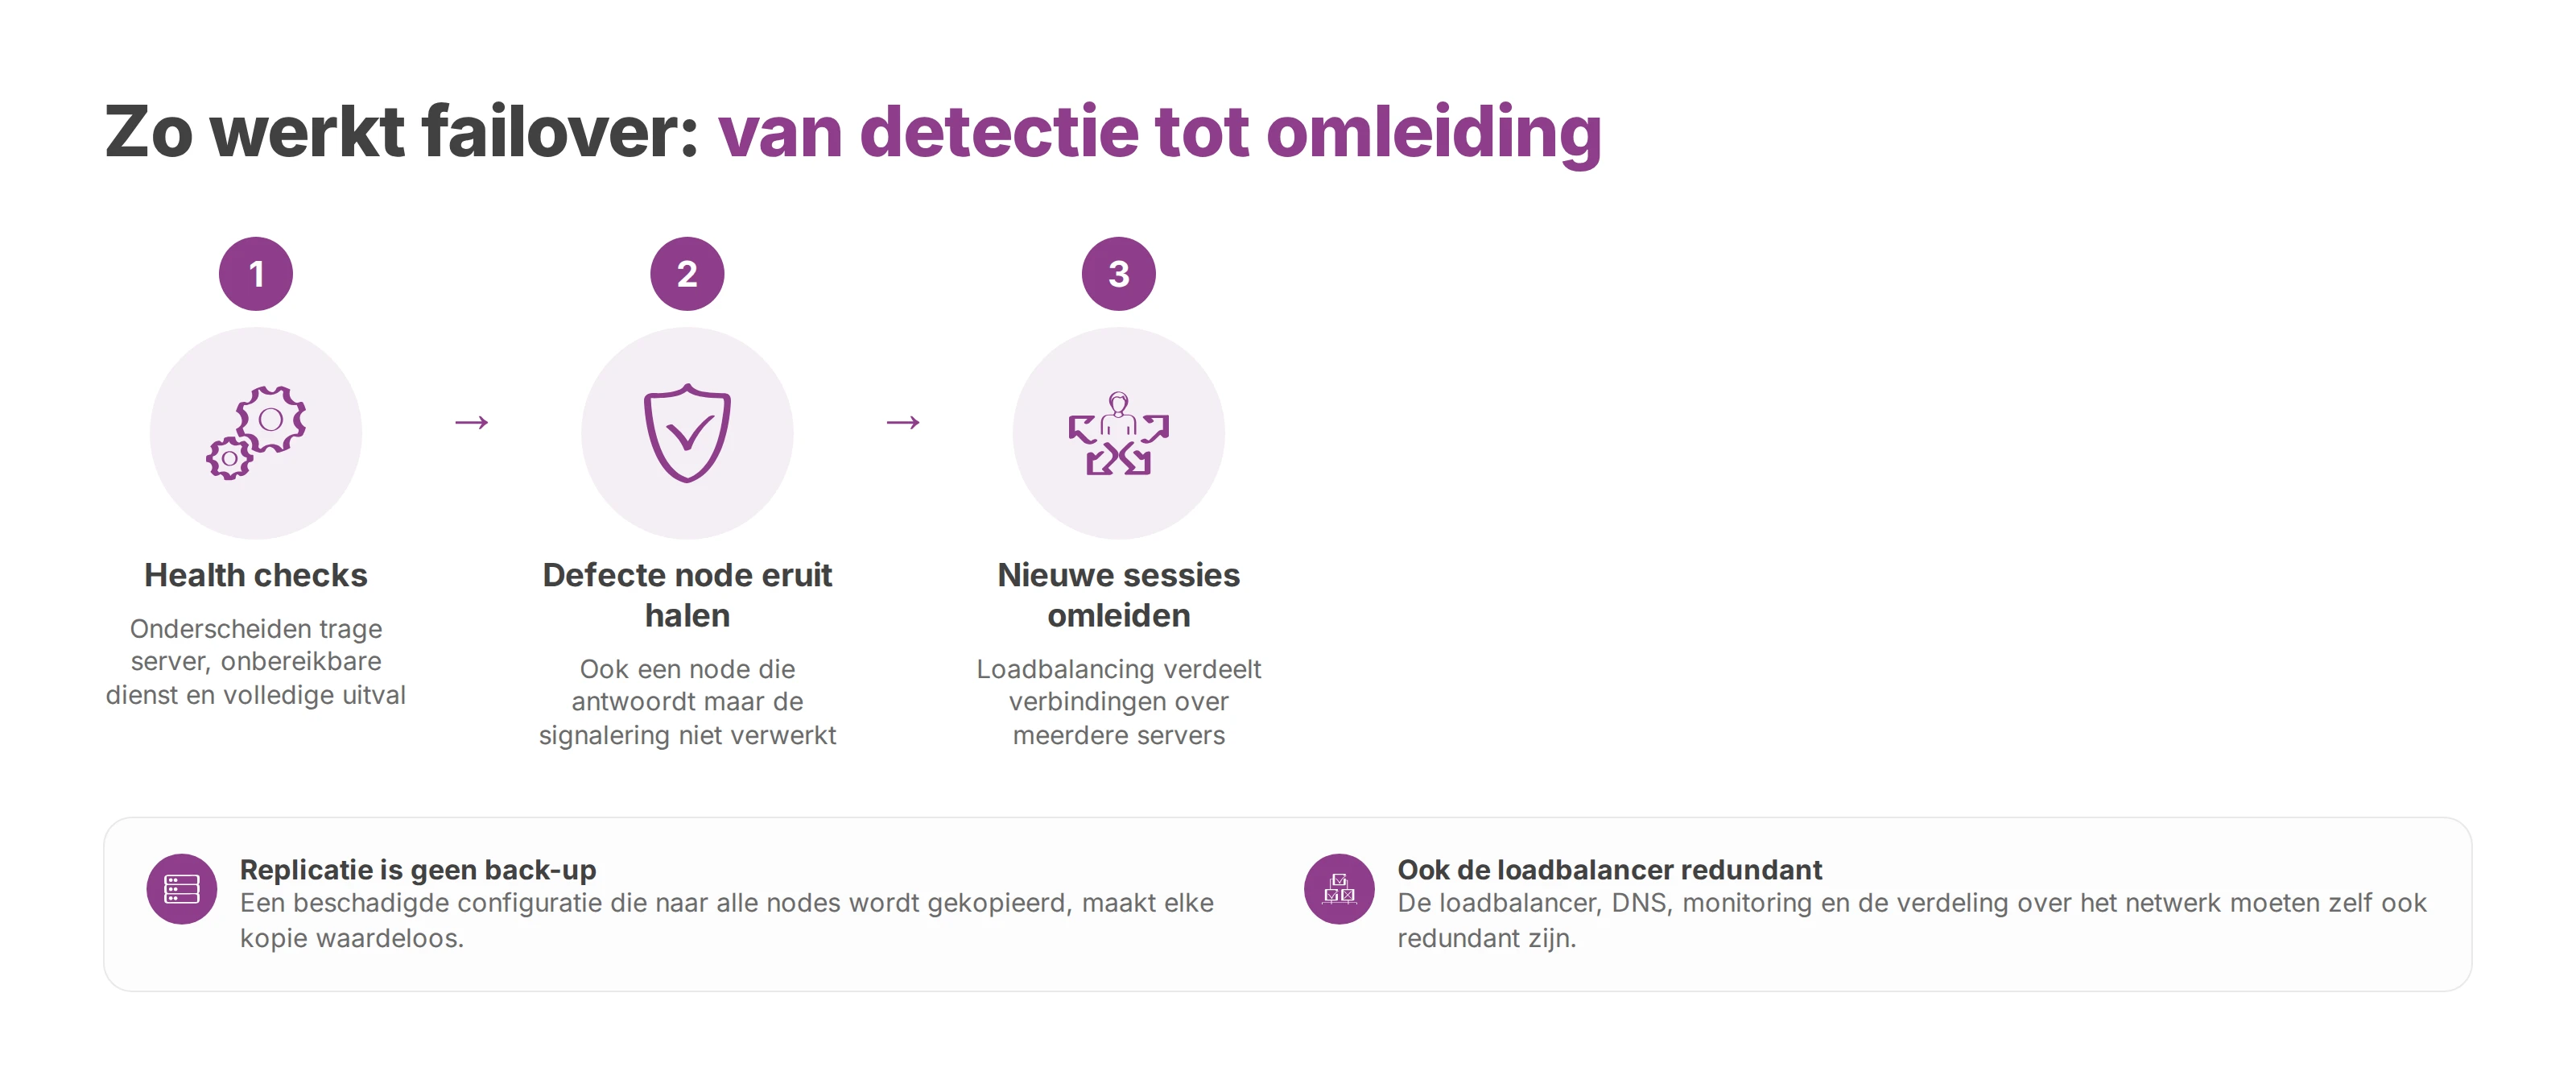
Automatische failover leunt op health checks die een trage server, een onbereikbare dienst en een volledige uitval van elkaar kunnen onderscheiden. Het systeem moet een defecte node uit het verkeer halen en nieuwe sessies omleiden. Het mag ook geen gesprekken meer sturen naar een node die op netwerkniveau nog antwoordt maar de signalering niet meer goed verwerkt.
Loadbalancing verdeelt verbindingen over meerdere servers en haalt zo knelpunten weg. Een slecht ontworpen datalaag los je er niet mee op. En de loadbalancer zelf moet redundant zijn, net als de naamresolutie (DNS), de monitoring en de verdeling over het netwerk.
Back-up en herstel
Replicatie is geen back-up. Een beschadigde configuratie of een verwijdering die naar alle nodes wordt gekopieerd, kan elke kopie waardeloos maken. Bewaar back-ups daarom geïsoleerd en versleuteld, controleer ze en zet ze regelmatig terug in een testomgeving.
Een failover die nooit getest is, is een aanname, geen herstelvermogen.
De integrator moet vastleggen wat er hoort te gebeuren als een node, een locatie, de opslag of de verbinding uitvalt. In de procedure staat wie de failover start, wie de inkomende gesprekken controleert en wie de terugkeer naar de normale situatie goedkeurt.
Datasoevereiniteit en een verbinding die blijft werken
Een datacenter in je eigen land is niet vanzelf soeverein. Dataresidentie zegt waar je data staat. Soevereiniteit hangt ook af van welk recht erop van toepassing is en welke autoriteit inzage kan eisen. Hoe dat verschil uitpakt, lees je in de uitleg over datasoevereiniteit.
Voor een cloud-PBX gaat die analyse over gesprekken, opnames als je die maakt, logbestanden, metadata, back-ups en beheertools. De Algemene verordening gegevensbescherming (AVG) stelt voorwaarden aan doorgifte van persoonsgegevens naar een land buiten de EER. De gedragscode van CISPE, de vereniging Cloud Infrastructure Service Providers of Europe, verplicht aangesloten aanbieders hun klanten de keuze te geven om data volledig binnen de EER op te slaan en te verwerken. Dan gelden die doorgifteregels niet.
Een datacenter dichtbij kan ook uitvallen
Nabijheid verlaagt soms de latency, maar het operationele risico blijft. In april 2023 veroorzaakte een lekkende koelwaterleiding brand in een datacenter van Google Cloud in de regio Parijs (europe-west9), en het hele gebouw ging uren zonder stroom. De regio telde drie gebouwen met eigen koeling, stroom en netwerk. Toch vielen veel diensten in de hele regio uit, omdat de replica's van een centrale database niet goed over die drie gebouwen verdeeld waren. Volgens het incidentrapport van Google is het getroffen cluster daarna buiten gebruik gesteld. Meerdere gebouwen in één regio beschermen je dus pas als de leverancier zijn diensten en data ook echt over die gebouwen verdeelt.
De blinde vlek van de lokale glasvezel
Je PBX kan bij de leverancier probleemloos draaien en op een vestiging met een doorgeknipte glasvezel toch onbruikbaar zijn. Gesprekken volgen hun gewone pad niet meer, toestellen verliezen hun registratie en gebruikers bereiken de wachtrijen en keuzemenu's niet.
Afhankelijk van hoe kritiek de vestiging is, moet je een 4G- of 5G-back-up regelen, een tweede operator met een fysiek gescheiden aansluiting of een gecontroleerde doorschakeling naar mobiele nummers. Bij meerdere vestigingen kan SD-WAN (software-defined wide area network) die verbindingen samen aansturen, op voorwaarde dat de back-uplijnen echt los van de hoofdlijn lopen. Hoe je doorschakeling en bereikbaarheid per vestiging inricht, staat in de gids over bereikbaarheid van je telefoon.
Implementatiechecklist voor IT-afdelingen en integrators
Een geslaagde implementatie begint bij de afhankelijkheden. De keuze van een interface komt later. De IT-afdeling en de integrator moeten samen een overzicht maken waarmee de beheerders in de praktijk kunnen werken, met nummers, vestigingen, operators, apparatuur, routeringsregels en escalatiecontacten.
Van inventarisatie naar doelen
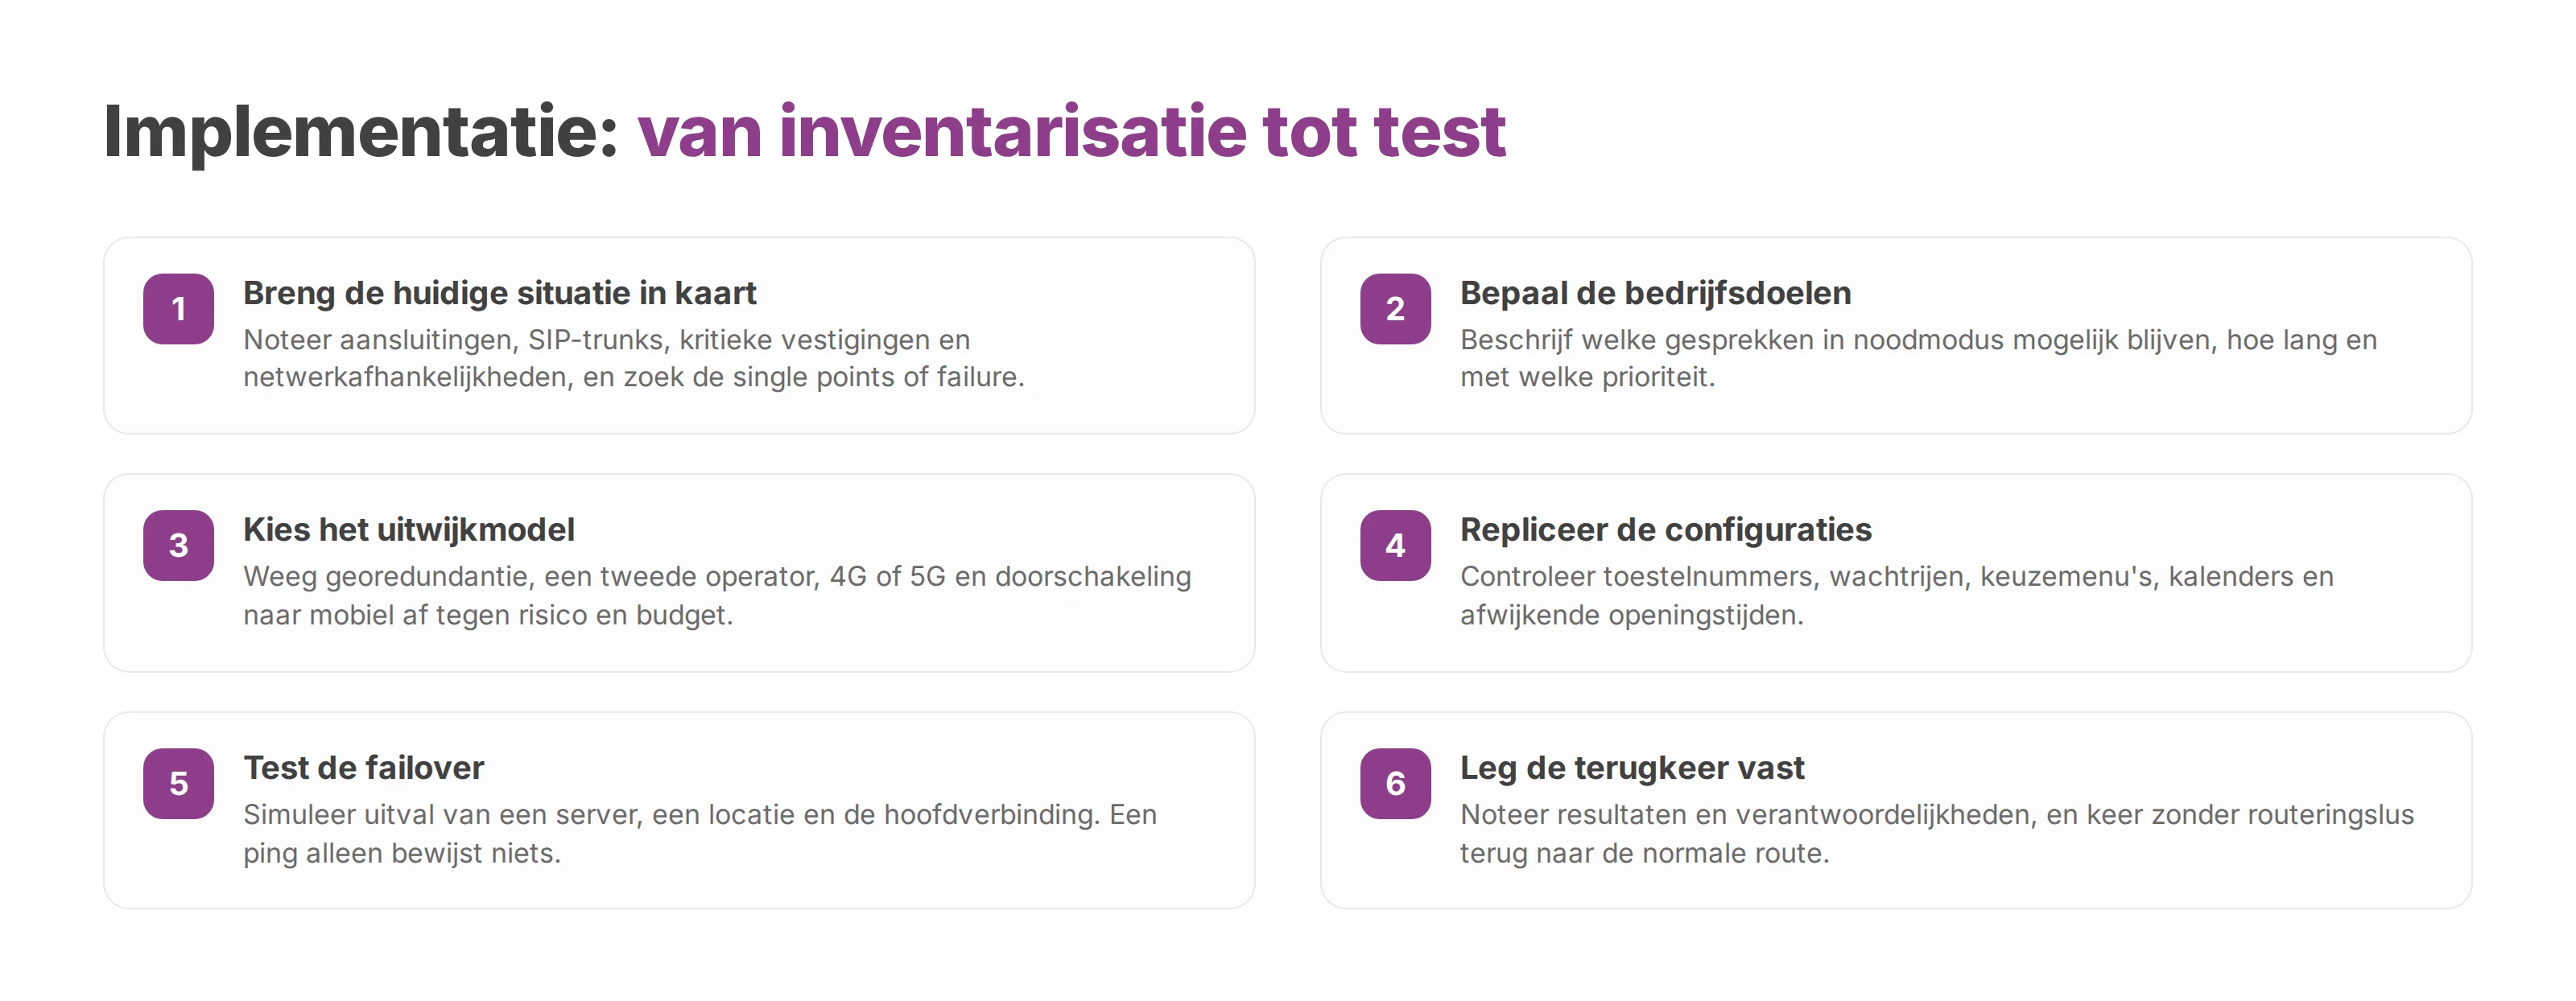
Breng de huidige situatie in kaart. Noteer de internetaansluitingen, de huidige telefonie, de SIP-trunks, de kritieke vestigingen, de apparatuur op een UPS (noodstroomvoeding) en de netwerkafhankelijkheden. Het resultaat moet de single points of failure onderscheiden van de onderdelen die echt redundant zijn.
Bepaal de bedrijfsdoelen. Je continuïteitsplan moet beschrijven welke gesprekken in noodmodus mogelijk moeten blijven, hoe lang en met welke prioriteit. Een spoedlijn, een patiëntenbalie en een administratieve centrale hebben niet per se dezelfde RTO.
Kies het uitwijkmodel. Zet georedundantie, active-passive, active-active, een tweede operator, 4G of 5G en doorschakeling naar mobiel naast elkaar. De oplossing moet passen bij het risico, het budget en de kennis die je in huis hebt.
Repliceer de configuraties. Controleer toestelnummers, wachtrijen, keuzemenu's, kalenders, afwijkende openingstijden en de regels voor de bereikbaarheidsdienst. Met een back-up waarin alleen de gebruikersaccounts staan, bouw je de dienst niet opnieuw op.
Test de failover. Simuleer uitval van een server, een locatie en de hoofdverbinding. Controleer inkomende en uitgaande gesprekken, doorverbinden, wachtrijen, meldteksten en de toegang tot het beheer. Een ping alleen bewijst niets.
Leg de terugkeer vast. Noteer resultaten, afwijkingen en verantwoordelijkheden. De procedure moet beschrijven wanneer je de back-uplijn gebruikt, hoe je gebruikers informeert en hoe je zonder routeringslus terugkeert naar de normale route.
Controleer en valideer de firewallregels vóór de livegang. De Voxbi-documentatie over firewallinstellingen is daarbij het controlepunt voor de integrator, die de configuratie daarna moet afstemmen op de apparatuur die er werkelijk staat.
Vragen voor je cloud-PBX-leverancier
Een goede aanbesteding vraagt om antwoorden die je kunt controleren, niet om een algemene belofte van veerkracht. De leverancier moet kunnen beschrijven hoe zijn architectuur eruitziet, wat het contract dekt en hoe een incident verloopt.
De datavraag moet ook opnames en metadata dekken, niet alleen accountgegevens. Wie een clouddienst kiest, moet ook de doorgiftes, de toegang van subverwerkers en het toepasselijke recht beoordelen.
Een serieuze leverancier moet je IT-afdeling een dossier leveren waarmee ze verder kan. Daarin staan de logische architectuur, de verantwoordelijkheden, de escalatiecontacten, de grenzen van de SLA, de voorwaarden voor doorschakeling en de testresultaten. Openheid over eerdere incidenten zegt meer dan een theoretische beschikbaarheid die niemand kan controleren.
Zo pak je het aan
Begin bij je eigen aansluiting, want daar zit vaak het gat. Een cloudleverancier kan een dienst die je vestiging niet meer bereikt, niet beschikbaar maken. Leg per vestiging de hoofdaansluiting vast, de uitwijkroute en wat er met gesprekken gebeurt in noodmodus.
Gebruik daarna de checklist en de vragentabel bij je volgende audit, contractverlenging of vervanging van je PBX. Leg de antwoorden van de leveranciers naast elkaar en let vooral op de rijen waar alleen een percentage staat. Vergelijk je nog aanbieders, dan vind je de basis in de complete gids over cloudtelefonie.
Neem het herstel van je telefonie tot slot op in je bedrijfscontinuïteitsplan. Oefen het en werk het bij na elke wijziging in de architectuur.
Voxbi is een telefooncentrale in de cloud, gehost in de Europese Unie. Gesprekken zijn beveiligd met SIP TLS en WebRTC. Wil je een cloud-PBX-architectuur, de continuïteitsopties of de plek ervan in je herstelplan doornemen, neem dan contact met ons op.