
Historique d'appel : usages concrets pour les équipes
Historique d'appel : rappels, suivi client, CRM, heures de pointe et durées de conservation pour les PME et ETI françaises.
16 nov. 2026
Dashboard call center : quels indicateurs suivre (taux de service, abandon, FCR, CSAT), comment les lire et piloter vos équipes au quotidien.
Le lundi matin, un responsable de centre d'appels ouvre le fichier de la semaine passée. Il y lit 4 200 appels traités, un temps moyen de 3 minutes 40 et une courbe rassurante. Le même jour, à 9 h 12, sa file compte onze appelants en attente et deux agents en pause. Le fichier ne le dit pas, et personne ne peut plus agir sur ce lundi.
Un dashboard call center répond à une autre question : que se passe-t-il maintenant, et que faut-il décider dans les dix prochaines minutes. La suite suit l'ordre d'un paramétrage réel, les indicateurs, leur lecture croisée, la construction des vues, le réglage des seuils, puis la protection des données et la validation avant mise en service.
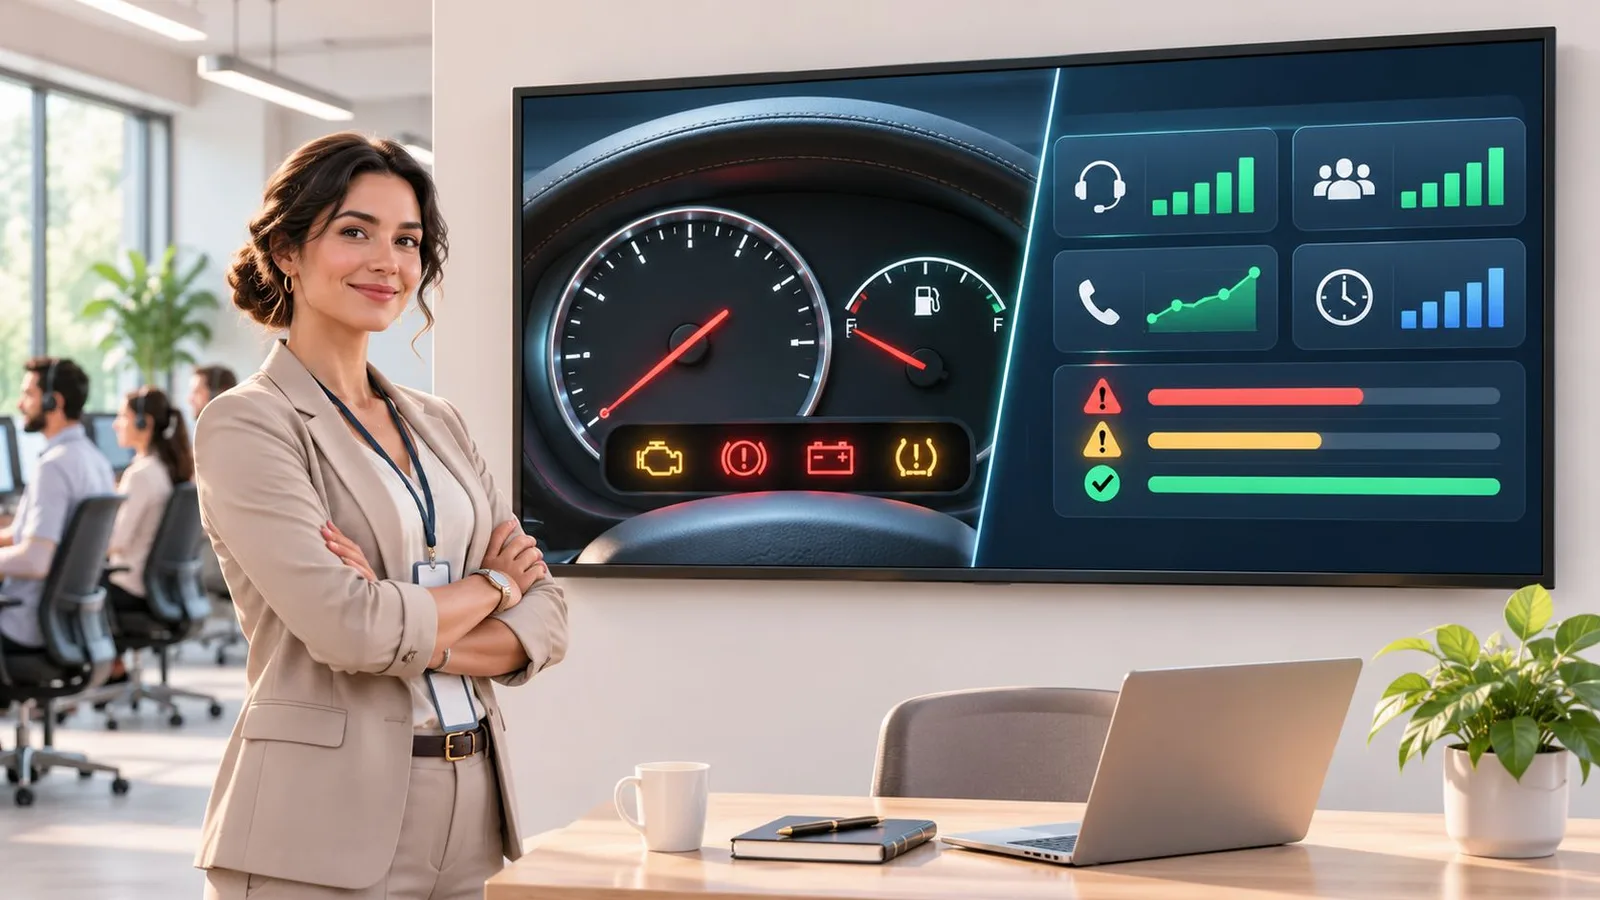
Un conducteur ne démonte pas le moteur pour savoir s'il doit ralentir. Il regarde la vitesse, le carburant et un voyant qui s'allume à temps. Un tableau de bord de centre d'appels rend le même service à une équipe téléphonique : appels en attente, agents disponibles, abandons et tendance de la journée, en une seule vue.
La différence avec un relevé d'appels tient au moment de la lecture. Le relevé compte les communications une fois la journée terminée. Le tableau de bord affiche l'état du service pendant qu'il tourne, quand une décision change encore quelque chose.
Quatre arbitrages reviennent tous les jours : ouvrir un poste supplémentaire, décaler une pause, corriger un menu vocal qui envoie les clients au mauvais service, basculer une partie des appels vers un autre site. Aucun ne demande une analyse trimestrielle. Tous exigent un chiffre lisible en moins de dix secondes.
Les lecteurs ne sont pas interchangeables non plus. Le responsable de centre d'appels suit les files et les compétences, le dirigeant de PME ou d'ETI regarde la tendance et le coût par contact, l'intégrateur IT et le revendeur télécom configurent les files, les horaires et les droits d'accès. Le même écran doit servir les trois, avec des vues distinctes.
Un point de cadrage avant d'entrer dans les chiffres. La segmentation n'est pas un raffinement de reporting. L'étude Businesscoot sur le marché français de la relation client relève en 2025 une progression de 9 % dans l'hôtellerie et le tourisme, contre un recul de 8 % dans les télécommunications et fournisseurs d'accès et de 12 % dans l'industrie. Une moyenne unique mélange ces réalités. Le tableau de bord se lit donc par activité, par file, par site et par période.
Les lignes ci-dessous suivent l'ordre dans lequel un responsable les consulte réellement : d'abord les volumes, puis les délais de prise en charge, puis la qualité de traitement.
| Indicateur | Ce qu'il mesure | Signal d'alerte |
|---|---|---|
| Volume d'appels entrants et sortants | Nombre d'appels par créneau et par file | Pic inhabituel ou chute brutale sans cause identifiée |
| Taux de prise en charge sous 30 secondes | Part des appels décrochés en moins de 30 secondes | Dérive sur deux créneaux consécutifs |
| Taux de prise en charge sous 3 minutes | Part des appels décrochés en moins de 3 minutes | Écart qui se creuse avec le taux sous 30 secondes |
| Délai moyen de réponse (ASA) | Temps moyen d'attente avant décroché | Hausse continue sur la semaine |
| Taux d'abandon avant réponse | Part des appelants qui raccrochent avant décroché | Hausse parallèle à l'attente |
| Taux de transfert | Part des appels transférés à un autre agent ou service | Transferts répétés sur un même motif |
| Taux de résolution au premier contact (FCR) | Part des demandes réglées sans rappel | Baisse alors que le délai de réponse s'améliore |
| Durée moyenne de traitement | Durée moyenne de conversation et de travail associé | Hausse sans gain de résolution |
| Réitérations à 7 jours | Part des clients qui rappellent pour le même motif | Hausse après un changement de process |
| Satisfaction client (CSAT) | Note moyenne donnée après le contact | Baisse sur un canal ou un motif précis |
| Taux de déflexion chatbot | Part des contacts traités sans agent | Baisse des appels sans baisse des réclamations |
Prise en charge sous 30 secondes, prise en charge sous 3 minutes et abandon avant réponse décrivent des phénomènes différents et doivent rester sur trois lignes séparées. Les données publiées par l'Arcep sur les services accessibles donnent la mesure des écarts possibles : selon le canal et le trimestre observés, certains services en langue des signes française descendent à 15 % de prises en charge en moins de 30 secondes, 26 % en moins de 3 minutes et 23 % d'abandons, comme le détaille l'observatoire de l'accessibilité téléphonique de l'Arcep.
Un taux correct sous 30 secondes peut masquer une file qui fuit : les appelants patientent deux minutes, puis raccrochent. Le délai moyen de réponse, lui, écrase tout dans une moyenne. Une ASA de 40 secondes peut recouvrir 80 % d'appels décrochés en dix secondes et 20 % d'appels qui ont attendu trois minutes. Les taux de prise en charge montrent la répartition, l'ASA montre le centre de gravité. On garde les deux.
Règle de calcul : le taux de service se calcule sur les appels réellement offerts, pas sur les appels décrochés. Sinon, une file qui perd des appelants paraît performante.
Les abandons très précoces, quelques secondes après l'annonce vocale, se suivent à part. Les mélanger au taux d'abandon global pénalise la file pour des communications qui n'ont jamais vraiment attendu. Un abandon à 90 secondes, en revanche, est un client qui renonce, et c'est cette valeur qui intéresse le pilotage.
Sans découpage par file, créneau de 15 ou 30 minutes, compétence, site et motif d'appel, le tableau de bord ne permet pas de choisir la bonne action. Le même symptôme peut demander un agent de plus, un horaire élargi, un rappel automatique ou une correction du menu vocal. Seule la vue segmentée tranche, et c'est là que la mécanique d'une file d'attente devient un objet de configuration et plus seulement d'observation.
Le taux de déflexion chatbot illustre le piège. En France, 31 % des consommateurs utilisent désormais un chatbot pour contacter un service client, mais seuls 50 % s'en déclarent satisfaits, contre 72 % pour le téléphone et 68 % pour l'e-mail, selon l'étude Businesscoot sur le marché du chatbot et de l'IA dans le service client. Une baisse des appels obtenue par des abandons ou des renoncements n'est pas un gain. Il faut donc mesurer les parcours bot vers agent, le taux de transfert, le délai avant reprise humaine et les réitérations dans les 7 jours.
Aucun de ces indicateurs ne se lit seul. C'est l'objet de la section suivante, et c'est là que la plupart des tableaux de bord perdent leur utilité.
Un taux de prise en charge en hausse passe facilement pour une bonne nouvelle. C'est parfois une dégradation. La différence se voit uniquement quand deux indicateurs sont posés côte à côte.
Règle de lecture : un indicateur ne vaut que par la paire qui le confirme ou le contredit. Abandon avec attente, FCR avec transferts, durée avec réitérations.
Premier cas, la file rapide mais inefficace. Le taux de prise en charge progresse, mais le FCR baisse et le taux de transfert augmente. Le service semble rapide, alors que les clients passent d'un agent à l'autre et rappellent le lendemain. La cause se trouve souvent dans le routage ou dans l'attribution des compétences, pas dans l'effectif. Ajouter un agent dans cette configuration accélère un circuit qui ne résout rien.
Deuxième cas, la conversation plus longue qui fait gagner. La durée moyenne de traitement augmente, mais les réitérations à 7 jours diminuent. L'appel plus long a évité un rappel, donc un second contact, un second temps d'attente et une insatisfaction. Ce n'est pas un défaut de productivité, c'est un gain de résolution. Un responsable qui coupe cette conversation pour tenir un objectif de durée dégrade le service en croyant l'améliorer.
Troisième cas, la baisse de volume trompeuse. Une baisse des appels n'est un gain que si l'abandon et le CSAT restent stables. Croiser le volume avec le taux d'abandon et la satisfaction suffit à trancher. Quand le volume chute en même temps que la satisfaction, la cause est souvent un parcours interrompu, pas un besoin mieux couvert.
Les chiffres de perception confirment l'écart entre délai et expérience. Une étude publiée en France rapporte que seuls 38 % des Français interrogés se déclarent satisfaits du temps d'attente pour être pris en charge, 62 % citant un temps d'attente trop long, 51 % le délai de résolution et 49 % l'incapacité à résoudre la demande au premier contact, selon l'étude Kiamo sur l'IA et la relation client.
Autrement dit, un centre peut tenir son délai moyen et décevoir quand même. La mesure par canal et par motif fait apparaître le motif mal servi que la moyenne masque. La conséquence est pratique : le modèle de données doit relier chaque interaction à son temps d'attente, sa durée, son statut de résolution, son transfert éventuel et un retour client. On identifie la cause avant de toucher aux effectifs.
Sept décisions précèdent le premier clic dans l'outil. Elles se prennent dans cet ordre, parce que chacune conditionne la suivante.
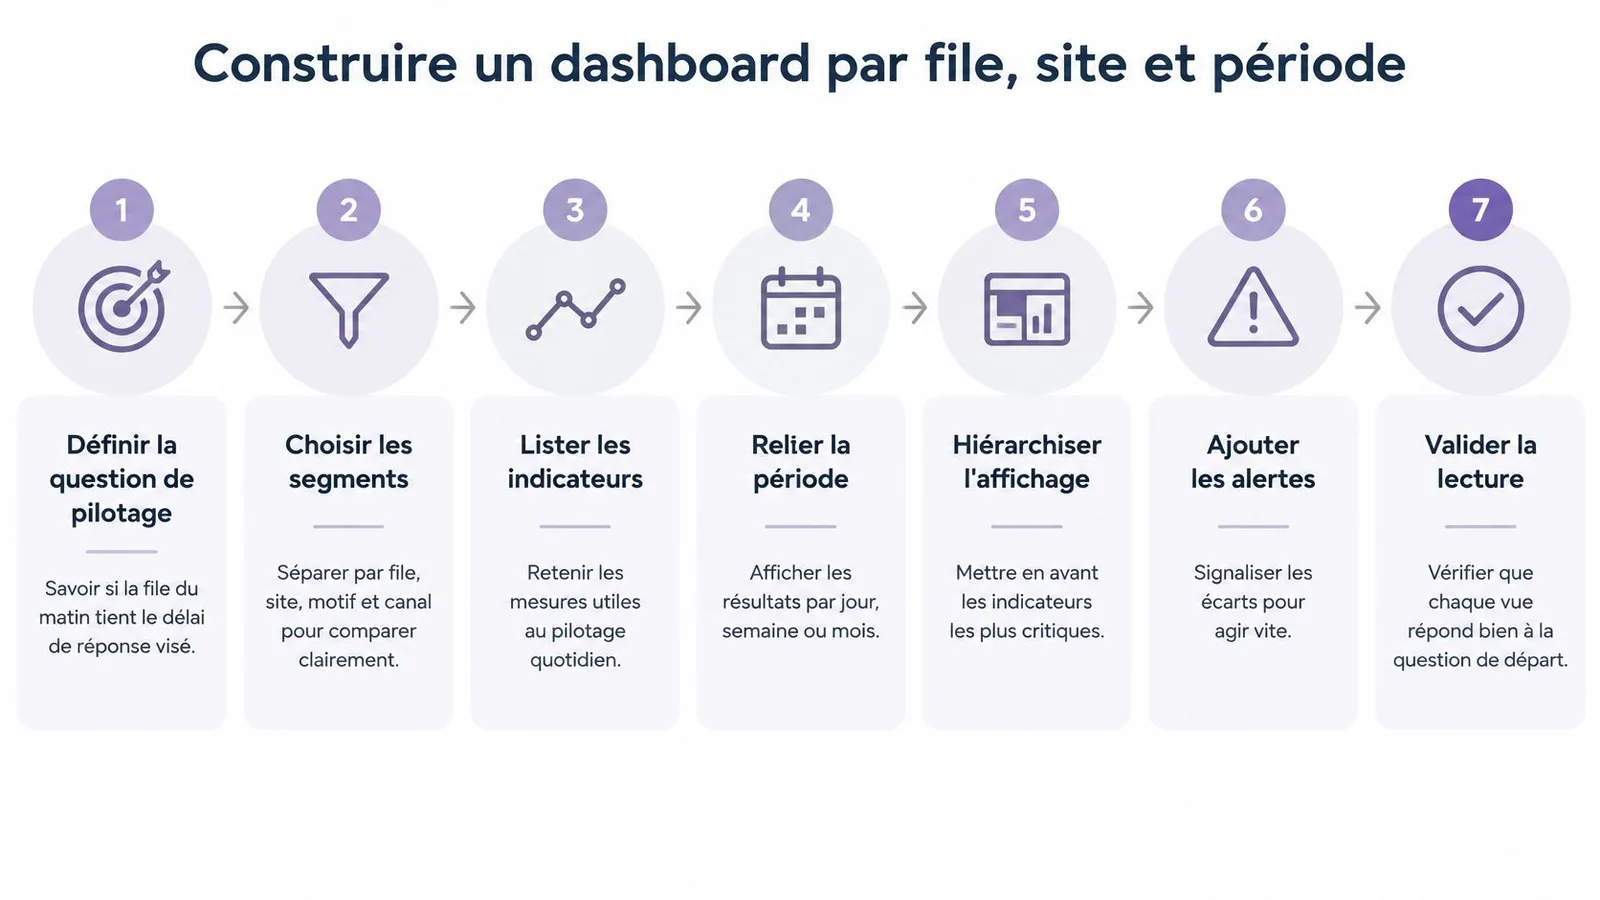
1. Formuler la question de pilotage. Par exemple : la file du matin tient-elle le délai de réponse visé. Sans cette phrase, chaque indicateur disponible finit affiché, et personne ne sait lequel regarder en cas de tension.
2. Choisir les segments. File, compétence, site, motif d'appel et canal. Un pic sans agent disponible et un pic avec des effectifs suffisants n'ont pas la même cause, et seul le segment le dit.
3. Fixer le pas de temps. Créneaux de 15 ou 30 minutes pour le temps réel, vues journalière et hebdomadaire pour les tendances. Un écran mensuel ne sert à rien pendant un pic, un écran à la seconde ne sert à rien pour décider d'un renfort à la semaine prochaine.
4. Relier le volume à la capacité. Un pic sans agent disponible n'appelle pas la même réponse qu'un pic avec des effectifs suffisants mais mal répartis.
5. Poser un seuil d'alerte par indicateur clé. Dont une alerte dédiée à la dérive du délai avant réponse, distincte de l'alerte d'abandon.
6. Isoler les abandons très précoces. Ils sortent du calcul de performance de la file, pour éviter de pénaliser une équipe sur des appels qui n'ont jamais attendu.
7. Attribuer les droits par rôle et tracer les consultations. Historiques et enregistrements ont une durée de conservation à définir, et un accès nominatif à journaliser.
La dernière brique n'est pas technique, elle est rituelle : une revue hebdomadaire courte où chaque alerte donne lieu à une décision écrite. Renforcer une file, réorganiser le menu, organiser des rappels, ou ne rien changer en expliquant pourquoi. C'est cette trace qui transforme l'écran en outil de décision.
Pour visualiser concrètement l'effet d'une réaffectation de file sur les voyants temps réel, la démonstration vidéo ci-dessous montre le basculement d'appels d'une file vers une autre et la réaction immédiate des compteurs.
Les objets manipulés dans ces vues, file, compétence, débordement, ont la même définition que dans la console d'administration. Comprendre le fonctionnement d'une file d'attente informatique évite les faux débats entre le rapport et la configuration réelle du standard.
Il n'existe pas de seuil universel, et c'est justement là que les projets se perdent. Un objectif de prise en charge se fixe avec l'équipe et avec la personne qui suit l'accord de niveau de service, pas en recopiant une valeur lue ailleurs.
Constituez la base de référence. Extrayez quatre à six semaines d'historique par file, créneau et site, en séparant les jours ouvrés des périodes exceptionnelles. Sans cette séparation, une semaine de fermeture ou un pic commercial fausse durablement la référence.
Regardez la dispersion, pas seulement la moyenne. Un délai moyen acceptable peut cacher des créneaux de pointe nettement plus lents. Calculez l'écart type ou le 90e centile par créneau. C'est ce dernier qui décide de l'expérience réelle des appelants du lundi matin.
Distinguez deux niveaux. Le seuil de vigilance déclenche une vérification par le superviseur. Le seuil d'action impose une décision écrite. Confondre les deux produit soit des alertes ignorées, soit des interventions pour du bruit.
Sur le délai avant réponse, préférez un seuil de dérive à une valeur absolue. Deux créneaux consécutifs en hausse signalent une tendance. Un pic isolé signale souvent un aléa.
Faites valider chaque seuil, puis datez-le. Le responsable d'équipe et la personne qui suit l'accord de niveau de service valident la valeur. Après tout changement de process, de menu vocal ou d'effectif, le seuil se révise. On documente la date et le motif, pour que la revue hebdomadaire puisse expliquer pourquoi une alerte a été levée ou maintenue.
Un tableau de bord mono-site répond bien à la question de la performance moyenne. Il ne répond pas à celle qui compte davantage en cas de tension : que se passe-t-il quand un site, une équipe ou un fournisseur devient indisponible ?
Le contexte ajoute de la pression. En 2025, le marché français de la relation client externalisée a généré 3,5 milliards d'euros, en recul de 1,4 %, tandis que les effectifs étudiés diminuaient de 3,6 % entre 2023 et 2025, d'après l'étude Businesscoot sur le marché des centres d'appels. Demande persistante, budgets contraints, effectifs en baisse : la vue moyenne ne suffit plus.
| Scénario | Indicateur à surveiller | Action |
|---|---|---|
| Un site devient indisponible | Capacité disponible par site | Basculer les appels vers un site de secours |
| Une équipe est en sous-effectif | Appels débordés et délai avant réponse | Activer un horaire exceptionnel ou un renfort |
| Pic saisonnier ou événement local | Volume par créneau comparé à l'historique | Ajuster les effectifs et le message d'attente |
| Panne d'un fournisseur de téléphonie | Taux d'appels non décrochés par numéro | Utiliser un numéro de repli et mesurer le délai de rétablissement |
| Agents hybrides répartis géographiquement | Présence et disponibilité par site | Réaffecter les files selon la capacité disponible |
Ce besoin est critique dans les hôpitaux, les EHPAD, les collectivités, les hôtels multi-sites et les organisations dont les agents travaillent en hybride. Dans ces structures, une file muette n'est pas un incident de reporting, c'est un service rendu qui s'arrête.
La distinction à garder en tête oppose deux exercices. Lire un accord de niveau de service consiste à comparer une performance à un engagement. Prouver la continuité pendant un incident exige autre chose : des journaux de bascule, l'horodatage des renvois de numéro, le délai de rétablissement mesuré, et une lecture par établissement plutôt qu'une consolidation. Ces éléments se conservent selon la politique définie plus loin, et c'est souvent la haute disponibilité réelle, testée, qui manque au dossier.
Un tableau de bord contient des historiques d'appels, parfois des enregistrements, toujours des métadonnées. Ces données désignent des personnes, et les chiffres de l'autorité de contrôle le rappellent : la CNIL a reçu 20 150 réclamations en 2025, soit une hausse de 10 % par rapport à 2024, et 6 167 violations lui ont été notifiées la même année, le piratage représentant un incident signalé sur deux, selon le rapport annuel 2025 de la CNIL.
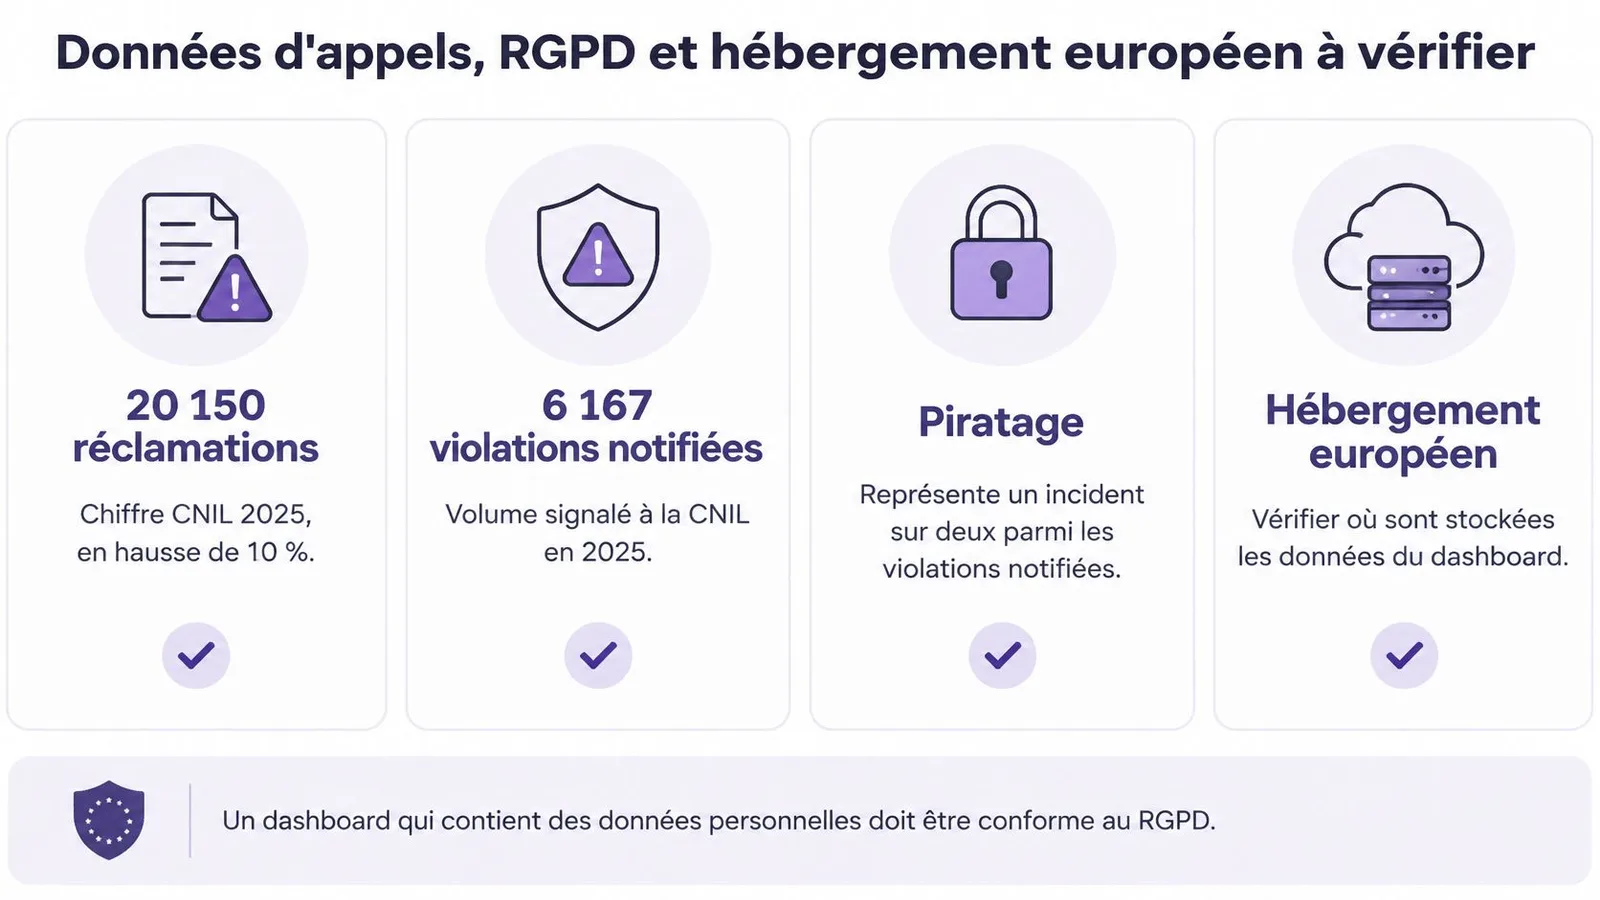
Trois notions se confondent souvent et ne se remplacent pas. La localisation des données indique où sont stockés les enregistrements. La conformité RGPD engage l'organisation responsable de traitement, ses finalités, ses durées et ses droits d'accès. Les obligations propres à l'IA dépendent de la fonction utilisée et de son rôle dans la chaîne de traitement.
Sur le premier point, Voxbi stocke les appels, les enregistrements et les métadonnées dans des centres de données situés dans l'Union européenne. Cela répond à la question de la localisation. Cela ne constitue pas, à soi seul, une preuve de conformité RGPD : le registre des traitements, la base légale, la durée de conservation et les droits des personnes restent à documenter par l'organisation.
Sur le troisième point, le calendrier européen interdit de présenter la conformité comme acquise. Les interdictions et les définitions s'appliquent depuis le 2 février 2025, les obligations de transparence de l'article 50 à partir du 2 août 2026, et les obligations relatives aux systèmes à haut risque de l'annexe III au 2 décembre 2027, selon la chronologie officielle du règlement européen sur l'IA. Une plateforme de téléphonie qui ajoute des fonctions d'IA documente donc son usage et sa trajectoire, elle ne décrète pas une conformité définitive.
Dans le tableau de bord, cela se traduit par des contrôles concrets : accès nominatifs par rôle, traçabilité des consultations, politique écrite de conservation et de suppression, et une démarche de conformité RGPD qui couvre aussi les exports de rapports.
Six points se valident avant tout paramétrage, dans l'ordre, parce qu'un tableau de bord mal cadré produit des chiffres que personne n'utilise.
Les indicateurs retenus, chacun accompagné de son indicateur de contrôle.
Les segments par file, site, motif, canal et créneau.
Les seuils de vigilance et d'action, avec leur date et leur motif.
Les droits d'accès par rôle et la traçabilité des consultations.
La durée de conservation des historiques et enregistrements, et la procédure de suppression.
La personne chargée de la revue hebdomadaire et le format de la décision écrite.
Le test sur un périmètre pilote reste la meilleure assurance. Un site, une file, plusieurs semaines, puis une comparaison entre les alertes produites et ce que l'équipe constate réellement. Une alerte qui se déclenche sans problème visible se régle, une alerte qui manque un incident se corrige aussi. C'est à ce prix que l'extension aux autres sites ne reproduit pas les mêmes angles morts.
Si la solution est hébergée dans le cloud, trois vérifications supplémentaires s'imposent : la localisation de l'hébergement, la journalisation des accès et la procédure en cas de violation de données.
Les briques existent déjà dans un standard cloud moderne. Les tableaux de bord temps réel affichent volumes, activité des files et tendances au moment où elles se produisent, et le Cockpit réunit utilisateurs, extensions, files, routage et analytique temps réel dans un seul onglet de navigateur. Lors du paramétrage, on ajoute les utilisateurs, on construit les flux d'appels et on connecte Odoo ou Microsoft 365 depuis le Cockpit, ou l'équipe Voxbi co-pilote cette étape.
Avant de déployer : choisissez la question de pilotage, fixez les seuils, et programmez la première revue hebdomadaire. Le reste est de la configuration.
Voxbi est un standard téléphonique cloud hébergé dans l'Union européenne, avec les appels, enregistrements et métadonnées conservés dans des centres de données européens et des garde-fous RGPD prévus dans la plateforme. Ses tableaux de bord temps réel et son Cockpit permettent de suivre les files, les temps d'attente et la disponibilité des agents, puis de modifier routage, files et menus vocaux sans ticket fournisseur. Pour cadrer un dashboard call center sur vos propres files, visitez Voxbi et testez la lecture de vos indicateurs sur un site pilote.
Historique d'appel : rappels, suivi client, CRM, heures de pointe et durées de conservation pour les PME et ETI françaises.
Communications unifiées : composantes, choix tout-en-un ou téléphonie connectée, déploiement multi-sites et checklist fournisseur pour les PME.
Prospection téléphonique en B2B : définition, règles en France, préparation des listes, guides d'appel et suivi des prospects, étape par étape.
Lancez un essai gratuit ou travaillez avec un partenaire Voxbi certifié.